So messen Sie, was Ihr KI-Agent im Kundenservice wirklich kostet
Ein häufiges Argument für einen KI-Agenten im Kundenservice sind sinkende Kosten pro Kundenkontakt. Im Januar 2026 hat Gartner eine Prognose veröffentlicht, die diese Rechnung infrage stellt: Bis 2030 sollen die Kosten pro gelöster Anfrage bei generativer KI im Kundenservice über 3 US-Dollar liegen. Damit wären sie potenziell höher als bei Servicekräften im B2C-Bereich.
Wie sich die Kosten Ihres eigenen Agenten entwickeln, können Sie zu einem großen Teil selbst steuern, vorausgesetzt, Sie messen sie nach dem Go-live regelmäßig und mit der richtigen Bezugsgröße. In diesem Beitrag zeigen wir, warum die Kosten pro Anfrage steigen können, welche Kennzahl wirklich zählt und wie Sie die Kosten Ihres Agenten steuern.
Warum die Kosten pro Anfrage nach dem Go-live steigen können
Gartner nennt für den Anstieg drei Treiber: steigende Kosten für Rechenzentren, KI-Anbieter, die von subventioniertem Wachstum auf Profitabilität umstellen, und Use Cases, die komplexer werden, mehr Tokens verbrauchen und teure Fachkräfte brauchen. Dazu kommt eine zweite Prognose: So könnten regulatorische Vorgaben zum Recht auf einen menschlichen Ansprechpartner das Volumen der von Menschen bearbeiteten Anfragen um 30 % erhöhen.
Neben diesen Marktfaktoren gibt es einen technischen Grund, der Sie direkt betrifft. Ein KI-Agent wird in der Regel pro verarbeitetem Token abgerechnet, und dieser Token-Verbrauch verhält sich im Betrieb anders als im Pilotprojekt. Im Pilot sind die Gespräche kürzer und die Anliegen einfacher. Im Produktivbetrieb schickt der KI-Agent bei jedem Gesprächsschritt den bisherigen Verlauf, die abgerufenen Dokumente und die Ergebnisse seiner Tool-Aufrufe erneut an das Modell, sodass jede weitere Nachricht teurer wird als die vorige.
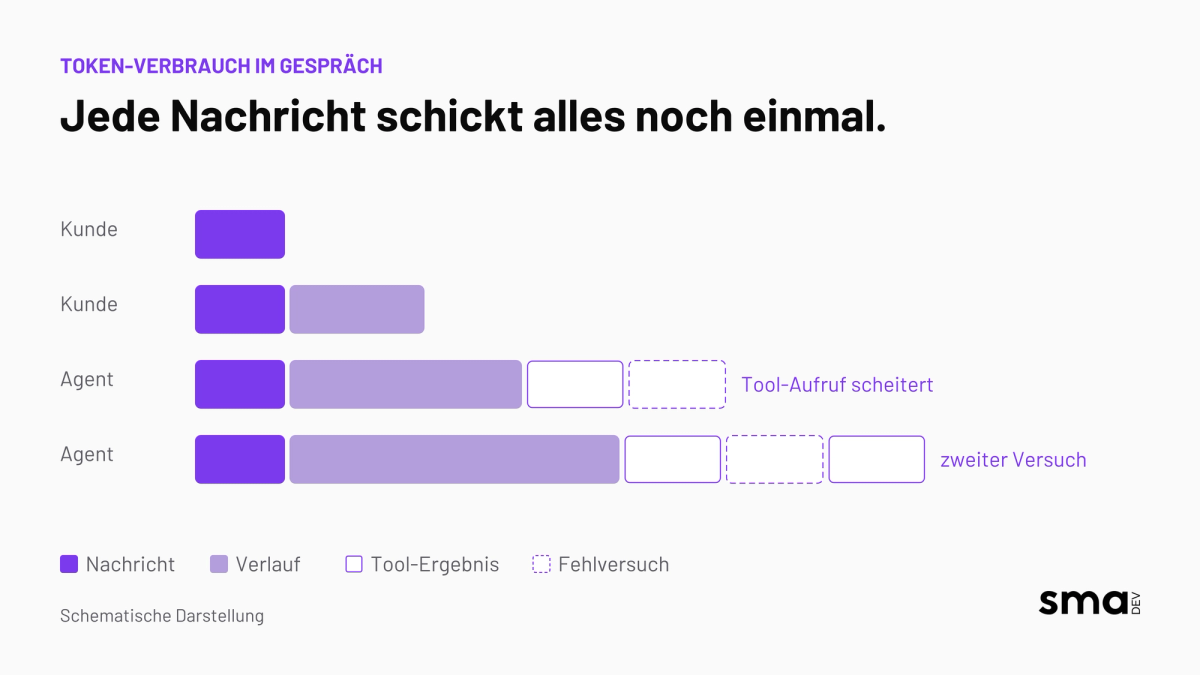
Besonders spürbar wird das, sobald der Agent Vorgänge selbst anstößt und dabei auf andere Systeme zugreift. Scheitert ein Tool-Aufruf, bleibt das Ergebnis im Kontext stehen und der Agent versucht es erneut. Die Kosten entstehen deshalb pro Gespräch, und wer nur die Kosten pro einzelner Antwort betrachtet, sieht diesen Anstieg nicht.
Diese Kosten können Sie direkt beeinflussen, wenn Sie die Qualität Ihres KI-Agenten im Kundenservice regelmäßig überprüfen und verbessern.
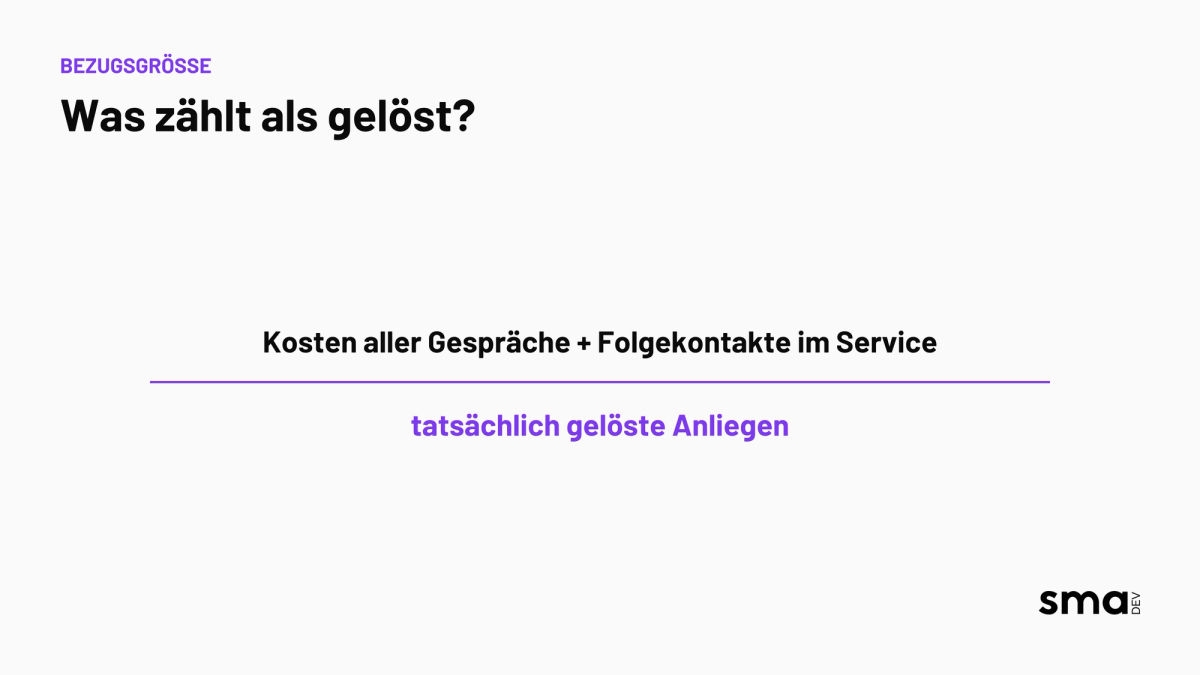
Entscheidend sind die Kosten pro gelöstem Anliegen.
Wenn wir in unseren Projekten fragen, wie gut ein KI-Agent im Kundenservice arbeitet, bekommen wir meistens Zahlen zu Verfügbarkeit, Antwortzeit und Kosten. Ob der Kunde sein Anliegen danach erledigt hatte, steht in diesen Zahlen nicht. Genau daran hängt aber, ob sich der Agent wirtschaftlich lohnt: Ein Chat, der günstig war und trotzdem mit einem Anruf beim Service endet, kostet Ihr Unternehmen am Ende zweimal.
Dass zwischen „korrekt beantwortet“ und „erledigt“ eine große Lücke liegen kann, zeigt ein Beispiel aus unserem Whitepaper: Ein Support-Bot erreicht 92 % Accuracy, seine tatsächliche Task-Success-Rate liegt aber bei nur 64 %, weil die Antworten zwar inhaltlich stimmen, aber am Bedarf der Nutzer vorbeigehen. Wer in diesem Fall die Kosten pro Anfrage betrachtet, rechnet sich den Agenten schön. Aussagekräftig sind die Kosten pro tatsächlich gelöstem Anliegen, einschließlich der Fälle, die danach doch beim Service landen.
Aus unserer Sicht sind Kosten außerdem ein wertvolles Qualitätssignal. Steigt der Verbrauch pro Gespräch, steckt dahinter oft ein inhaltliches Problem: Der Agent ruft ein Tool mehrfach auf, weil der erste Versuch scheitert, oder das Gespräch zieht sich, weil der Kunde sein Anliegen mehrmals erklären muss. Wer Kosten und Qualität gemeinsam misst, erkennt solche Muster früh und kann gezielt gegensteuern. Wie Sie die Qualität nach dem Go-live messen, lesen Sie im ersten Teil dieser Serie.
Was „gelöst“ heißt, entscheidet über die Rechnung.
Viele Plattformanbieter rechnen ihre KI-Agenten inzwischen pro Lösung ab statt pro Token. Das klingt nach einer klaren Kennzahl, doch was als Lösung zählt, legt jeder Anbieter selbst fest.
Fin (ehemals Intercom) berechnet zum Beispiel eine Lösung, wenn der Kunde nach der letzten Antwort bestätigt, dass ihm geholfen wurde, oder wenn er das Gespräch verlässt, ohne weitere Hilfe anzufordern. Zusätzlich rechnet Fin Übergaben ab, bei denen der Agent einen hinterlegten Ablauf ausführt und das Gespräch danach wie vorgesehen an einen Menschen übergibt. Zendesk berechnet seit Mai 2026 dagegen nur Gespräche, in denen der Kunde keine weitere Hilfe angefordert hat und ein Sprachmodell anhand des Gesprächsverlaufs bestätigt, dass das Anliegen zufriedenstellend gelöst wurde.
Ein Gespräch, das mit der KI beginnt und bei einem Menschen endet, kann also je nach Anbieter abgerechnet werden oder nicht. Und ein Kunde, der nach einer Antwort einfach nicht mehr schreibt, kann sein Anliegen erledigt oder entnervt aufgegeben haben. Fin rechnet diesen Fall laut eigener Hilfeseite als Lösung ab, bei Zendesk entscheidet die Prüfung durch das Sprachmodell.
Prüfen Sie deshalb vor der Entscheidung für einen Anbieter genau, was dieser als Lösung abrechnet, und gleichen Sie die abgerechneten Lösungen im Betrieb regelmäßig mit Ihren eigenen Zahlen ab, etwa mit den Kontakten, die kurz nach einem Chat beim Service eingehen. Wer die volle Kontrolle darüber haben möchte, wann ein Anliegen als erledigt gilt und wie Erfolg gemessen wird, kann auch eine eigene Lösung entwickeln lassen. Dann definieren Sie die Kennzahlen selbst und zahlen für den tatsächlichen Verbrauch statt pro abgerechneter Lösung. Die Kosten pro Gespräch sollten Sie dann aber von Anfang an mitmessen.
Wie Sie die Kosten Ihres KI-Agenten steuerbar machen
Legen Sie die richtige Bezugsgröße fest. Rechnen Sie mit den Kosten pro gelöstem Anliegen und zählen Sie dabei auch die Kontakte mit, die nach einem Chat beim Service eingehen. Der Service weiß meist am besten, bei welchen Themen Kunden trotz Chat noch anrufen.
Messen Sie pro Gespräch statt pro Antwort. Erfassen Sie die durchschnittlichen Betriebskosten pro Gespräch und zusätzlich die Kosten der teuersten Gespräche, etwa der oberen 5 %. Aufgeschlüsselt nach Modellaufruf, Tool-Aufruf und Dokumentensuche sehen Sie, wo die Kosten tatsächlich entstehen.
Halten Sie beim Go-live eine Basislinie fest und prüfen Sie jede Änderung dagegen. Ein neuer Prompt, ein anderes Modell oder eine erweiterte Wissensbasis verändern Qualität und Kosten gleichzeitig. Wenn Ihre Regressionstests beides messen, entscheiden Sie bei jedem Release auf Basis von Daten, ob sich die Änderung lohnt. Wie Sie Ihren Agenten Schritt für Schritt verbessern, zeigt der zweite Teil dieser Serie.
Prüfen Sie die Abrechnungslogik Ihres Anbieters. Klären Sie, was Ihr Anbieter als Lösung zählt, und stellen Sie Ihre eigene Messung daneben. So wissen Sie, wofür Sie bezahlen und wie viele Anliegen tatsächlich erledigt sind.
Setzen Sie technische Hebel gezielt ein. Begrenzte Kontexte, zusammengefasste Gesprächsverläufe und das Zwischenspeichern wiederkehrender Prompt-Teile können den Token-Verbrauch deutlich senken. Ob eine Optimierung die Antwortqualität beeinflusst, zeigt Ihnen erst die gemeinsame Messung von Kosten und Qualität.
Damit die Kennzahlen regelmäßig angeschaut werden, gehört der Agent als fester Punkt in einen bestehenden Jour fixe, an dem Service, Produktteam, IT oder Dienstleister und eine Person mit Budgetverantwortung aus dem Fachbereich teilnehmen.
Wie SMA Dev Sie dabei unterstützt
Mit AI-Evals machen wir Qualität und Kosten Ihres Agenten gemeinsam messbar. Am Anfang steht ein Audit, in dem wir reale Gespräche und Traces auswerten und daraus ein realistisches Bild der aktuellen Qualität und der Kosten pro Anliegen gewinnen. Darauf baut eine Eval-Suite auf, die bei jeder Änderung am System automatisch läuft und neben Antwortqualität und Task-Success auch die Kosten pro Anfrage prüft.
Tracing zeigt bei Auffälligkeiten, an welcher Stelle der Verarbeitungskette die Kosten entstehen, von der Dokumentensuche über die Tool-Aufrufe bis zur finalen Antwort. Nach dem Go-live beobachtet ein laufendes Monitoring, ob Kosten oder Qualität abdriften, und die Erkenntnisse fließen zurück in Analyse und Tests.
Im kostenlosen Strategie-Gespräch klären wir in 30 Minuten Ihre Ausgangslage. Danach wissen Sie, ob AI-Evals für Ihren Agenten jetzt Priorität haben, welcher Ansatz zu Ihnen passt und mit welchem Aufwand Sie realistisch rechnen können.
→ Kostenloses Gespräch vereinbaren
Häufige Fragen zu den Kosten von KI-Agenten im Kundenservice
Was kostet ein KI-Agent im Kundenservice pro Anfrage?
Das hängt vor allem vom Token-Verbrauch pro Gespräch ab. Lange Verläufe, viele abgerufene Dokumente und wiederholte Tool-Aufrufe machen ein Gespräch teurer. Gartner erwartet, dass die Kosten pro gelöster Anfrage bei generativer KI im Kundenservice bis 2030 über 3 US-Dollar liegen.
Warum wird ein KI-Agent nach dem Go-live teurer als im Pilot?
Im Produktivbetrieb sind die Gespräche länger und die Anliegen komplexer als im Pilot. Der Agent schickt bei jedem Schritt den bisherigen Verlauf erneut an das Modell. Jede weitere Nachricht kostet deshalb mehr als die vorige.
Worin unterscheiden sich Kosten pro Anfrage und Kosten pro gelöstem Anliegen?
Die Kosten pro Anfrage zeigen, was eine Antwort technisch kostet. Die Kosten pro gelöstem Anliegen zeigen, was es kostet, dass der Kunde sein Problem tatsächlich erledigt hat. Dazu zählen auch die Kontakte, die nach einem Chat noch beim Service eingehen.
Wie prüfe ich, was mein Anbieter als „gelöst“ abrechnet?
Lassen Sie sich die Abrechnungslogik vor Vertragsabschluss genau erklären. Gleichen Sie die abgerechneten Lösungen im Betrieb mit Ihren eigenen Zahlen ab, etwa mit Anrufen kurz nach einem Chat.
Wie senke ich die Kosten, ohne die Antwortqualität zu verschlechtern?
Begrenzte Kontexte, zusammengefasste Gesprächsverläufe und das Zwischenspeichern wiederkehrender Prompt-Teile senken den Verbrauch. Messen Sie Kosten und Qualität dabei gemeinsam, damit Sie sehen, ob eine Einsparung die Antworten verschlechtert.
Aus dem Blog
Weitere Insights & Aktuelles.
Decision Model im Kundenservice: Jev senkt Kosten
Ihr KI-Agent trifft in jedem Gespräch mehrere Entscheidungen im Hintergrund, und häufig bezahlen Sie dafür ein großes Sprachmodell. Hier lesen Sie, welche dieser Entscheidungen ein Decision Model wie Jev günstiger übernimmt und wie Sie das mit Ihren eigenen Chats prüfen, bevor Sie umstellen.
Mehr lesen→
KI-Agent im Kundenservice verbessern
Ihr KI-Agent ist live, und jedes Team kümmert sich um seinen Teil. Wer schaut regelmäßig in seine Chats und macht ihn besser?
Mehr lesen→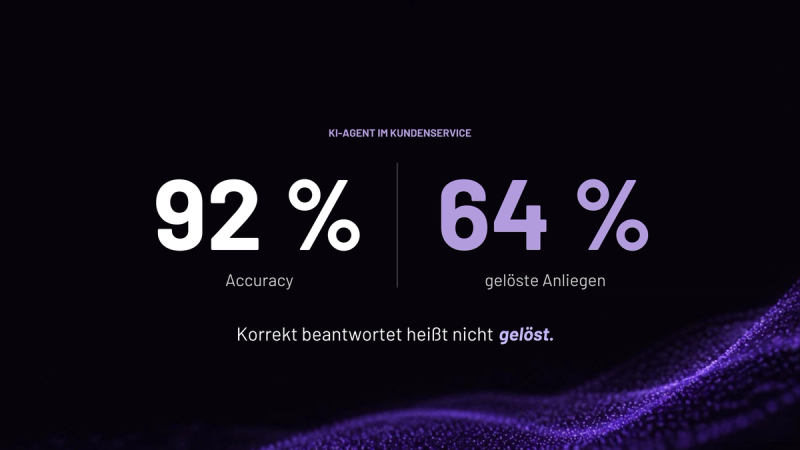
KI-Agent im Kundenservice: Qualität nach dem Go-live prüfen
Ihr KI-Agent im Kundenservice antwortet schnell und sachlich richtig. Trotzdem rufen Kunden danach an. Wer prüft, ob er Anliegen wirklich löst? Sechs Fragen und eine Routine für Service, Produktteam und IT.
Mehr lesen→
AI Evals: Fünf Dimensionen für produktive KI-Systeme
Im laufenden Betrieb Ihres KI-Systems fallen Ihnen drei Dinge auf. Der Token-Verbrauch steigt von einem Sprint zum nächsten um 40 %, ohne dass eine Konfigurationsänderung das erklären würde. Nach einem Prompt-Update verändert sich die Antwortqualität spürbar; das Team empfindet sie als schlechter, kann aber nicht benennen, warum. Und Ihr RAG-System liefert Aussagen, die in keinem […]
Mehr lesen→
LLM-Halluzinationen: Warum korrekte Daten das Problem nicht lösen
Ein KI-System hat die AGB Ihres Unternehmens vollständig geladen. Es kennt jeden Paragraphen. Und trotzdem verspricht es einem Kunden eine Leistung, die rechtlich nicht gedeckt ist. Das passiert täglich in Systemen, die längst als produktionsreif gelten. Der Grund liegt nicht im fehlenden Datenzugriff. Er liegt darin, wie das Modell mit den Daten umgeht. Was ist […]
Mehr lesen→
Fehlerfreie KI-Anwendungen entwickeln: Die Vorteile von AI-Evaluations
Die Herausforderungen in KI-Projekten verschieben sich drastisch: Wir sprechen nicht mehr von Systemabstürzen, sondern vom sogenannten „Silent Failure“. Anwendungen liefern technisch einwandfreie Datenpakete aus, während der inhaltliche Kern zu halluzinieren beginnt, Compliance-Richtlinien verletzt werden oder die Markenreputation durch einen falschen Tonfall gefährdet wird. Technisch gesehen ist das System ein Erfolg. Der Live-Betrieb liefert jedoch andere […]
Mehr lesen→