
KI-Agenten im Kundenservice: Wer prüft die Qualität nach dem Go-live?
KI-Agenten im Kundenservice: Wer prüft die Qualität nach dem Go-live?
Extremwetter wird in Deutschland intensiver und häufiger. Das hat der Deutsche Wetterdienst im September 2026 auf dem Extremwetterkongress erneut festgestellt. Zusammen mit Streiks und Großereignissen legt es den Reiseverkehr immer wieder lahm.
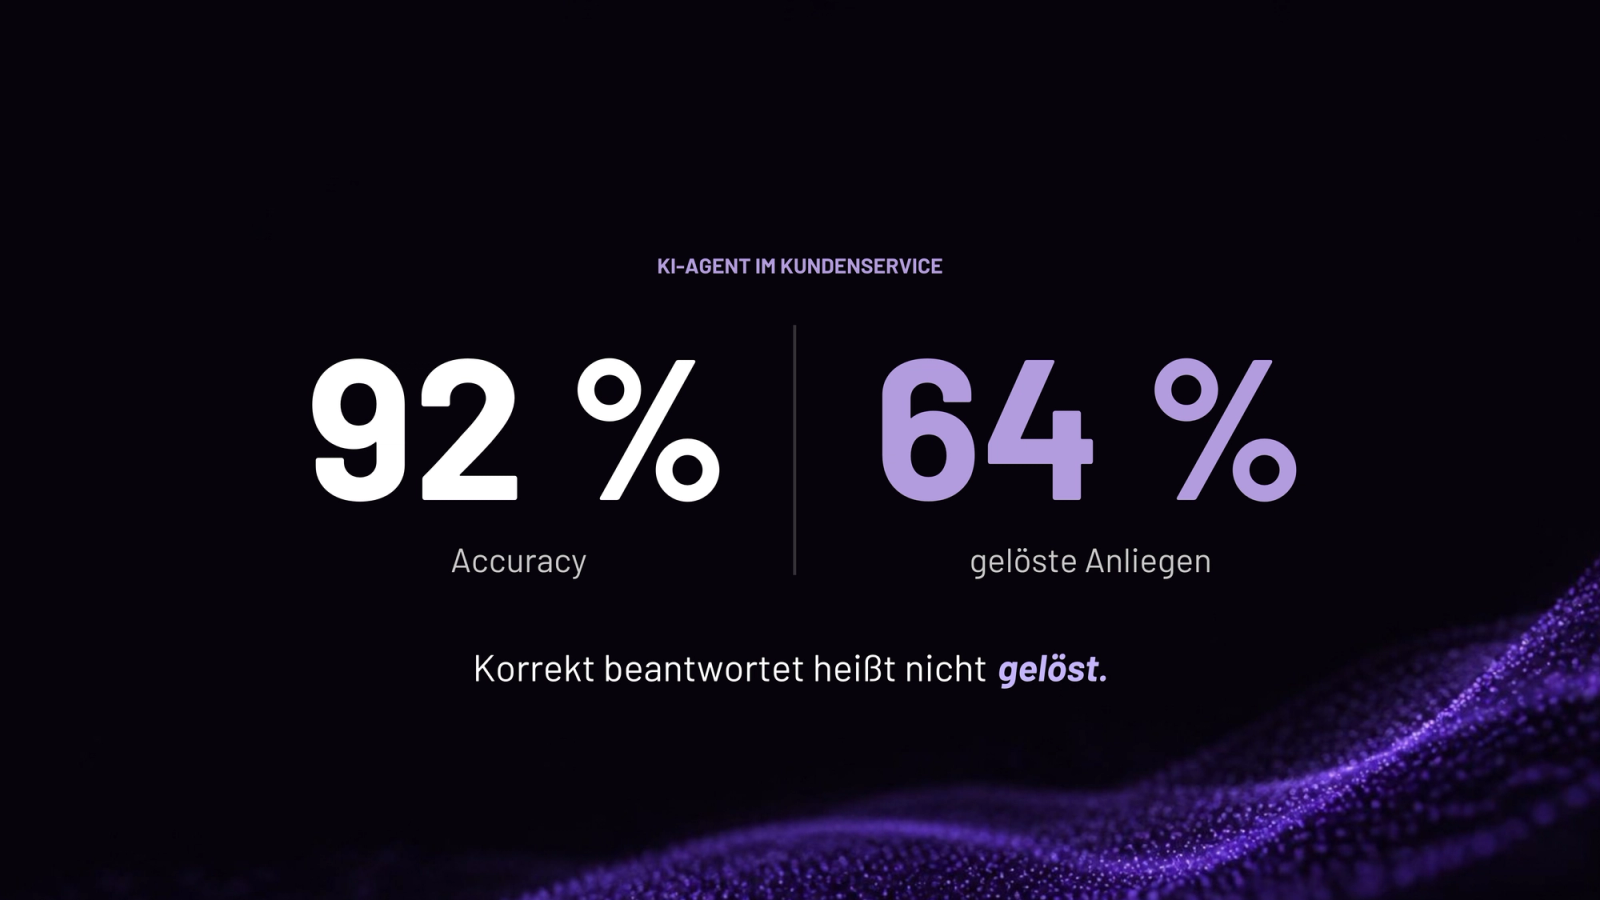
Wenn dann tausende Kunden gleichzeitig umbuchen, stornieren oder zu einem anderen Mobilitätsanbieter wechseln wollen, beantwortet jeder KI-Agent im Kundenservice geduldig jede Anfrage. Viele Kunden bekommen dabei tatsächlich eine sachlich richtige Antwort, die aber leider ihr Anliegen verfehlt. Diese Kunden rufen danach an. Oder sie geben entnervt auf. Eine ähnliche Erfahrung kennen wir alle aus dem eigenen Alltag.
Für das Team, das den Agenten gebaut hat, verläuft so ein Tag technisch einwandfrei. Der Agent war die ganze Zeit erreichbar und hat schnell geantwortet. Ob er die Anliegen gelöst hat, erfährt das Team oft erst Tage später, über Beschwerden, die beim Service landen.
In diesem Blogartikel analysieren wir anhand dieses Beispiels die häufigsten Fehlerquellen und zeigen, warum es sich lohnt, die Qualität von Kundenservice-Agenten regelmäßig zu prüfen und weiterzuentwickeln.
Die Kollegen im Service hören als Erste, wenn der Agent danebenliegt.
Am Morgen nach einem Tag voller Umbuchungen erzählen Mitarbeitende in der Teamrunde, was sie am Telefon gehört haben: Viele Anrufer waren vorher bereits im Chat. Das Service-Team kennt die Sorgen und Kontaktgründe der Kunden aus erster Hand. Es weiß, wie Kunden fragen, wenn sie unter Zeitdruck stehen, und welche Antwort sie wirklich weiterbringt.
Die Leitung des Kundenservice wird an Lösungsquote und Kundenzufriedenheit gemessen. Dass der Agent danebenliegt, erfährt sie aber meist erst über Wiederanrufer, Eskalationen und Bewertungen. Dabei gilt ein einfacher Maßstab: Wenn Kunden nach dem Chat trotzdem anrufen, war das Anliegen nicht gelöst, egal was das Reporting zählt.
Genau diesen Maßstab bildet im Service eine übliche Kennzahl ab: die Erstlösungsquote (First Contact Resolution), also der Anteil der Anliegen, die ohne Folgekontakt gelöst werden. Service- und Produktteam schauen damit auf dieselben Zahlen. So werden aus Geschichten vom Flur zumindest Indizien für die nächste Budget- und Personalplanung.
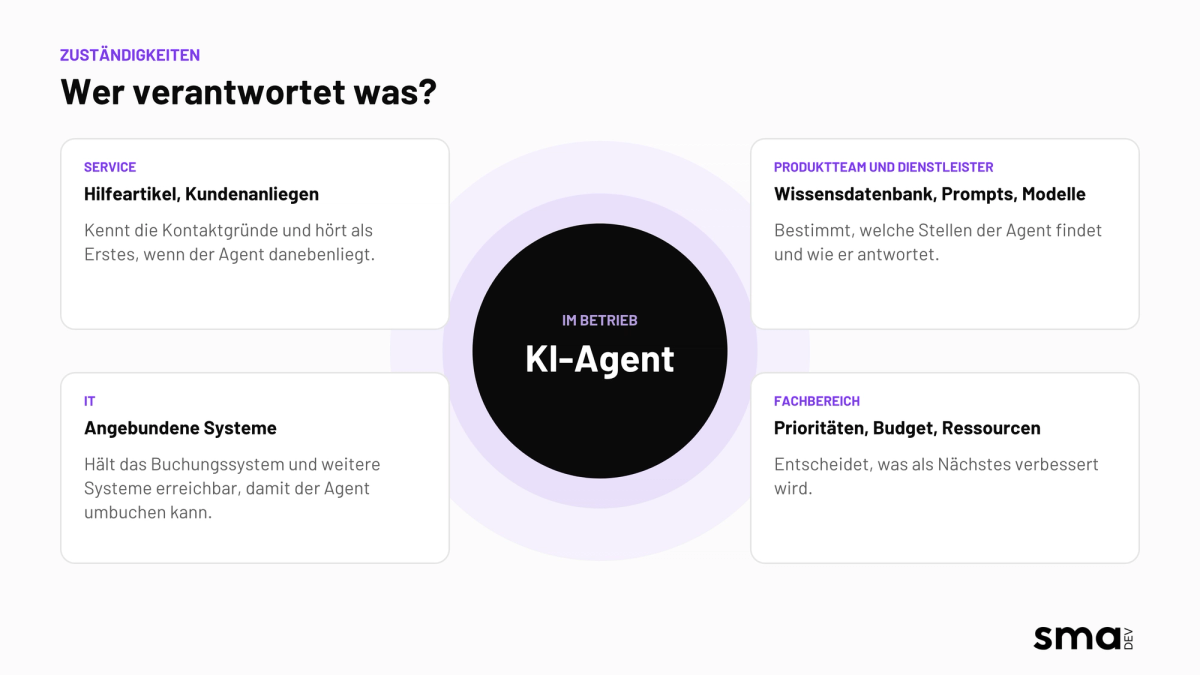
Für die Personalplanung ist dabei eines entscheidend: Jedes Anliegen, das der Agent vollständig abschließt, erspart dem Service-Team teure Nacharbeit. Um das zu erreichen, hilft ein Blick in die Chatverläufe und in die Technik dahinter. Die systematischen Ursachen für offene Anliegen liegen nämlich gern im toten Winkel: irgendwo zwischen den Hilfeartikeln des Service und der Technik, die wiederum Produktteam, IT und Dienstleister verantworten.
Warum antwortet der Agent trotz neuer Regeln falsch?
Wenn Gewitter wie im Juni den Betrieb am Frankfurter Flughafen in einer Nacht dreimal unterbrechen, gelten womöglich neue Kulanzregeln für Umbuchungen und Erstattungen. Der Service passt den Hilfeartikel an, und damit scheint die Sache erledigt. Ob sie es ist, hängt von mehr ab als vom Hilfeartikel. Die Entscheidung fällt zwischen den Gewerken:
- Gliederung und Verschlagwortung: Vor jeder Antwort sucht der Agent die Stellen heraus, die zur Frage passen. Fachleute nennen dieses Verfahren RAG (Retrieval-Augmented Generation). Wie gut er dabei trifft, hängt davon ab, wie die Inhalte gegliedert und verschlagwortet sind. Das richten Produktteam und Dienstleister ein.
- Veraltete oder doppelte Inhalte: Bleibt die alte Fassung neben der neuen in der Wissensdatenbank, findet der Agent unter Umständen beide. Seine Antwort klingt dann richtig und ist trotzdem veraltet. Hier sind Fachbereiche und Services gefragt, die Hilfeartikel und Richtlinien pflegen.
- Anweisungen und Modell-Updates: Bereits kleine Änderungen am Prompt verändern, wie der Agent Fragen versteht und Antworten formuliert. Beides muss Ihr Dienstleister in Ihrem Auftrag im Blick behalten.
- Verfügbarkeit der angebundenen Systeme: Ist das Buchungssystem nicht erreichbar, kann der Agent keine Umbuchung auslösen. Dafür sorgt die IT.
Einiges davon fällt erst auf, wenn der Kunde anruft. Wo solche RAG-Probleme ursächlich entstehen und warum sie lange unbemerkt bleiben, erklärt ein eigener Beitrag.
Ein kurzer Test mit ein paar typischen Fragen verrät, ob der Agent die neue Regelung richtig wiedergibt. Wie sich das Update auf alle anderen Anliegen auswirkt, macht allerdings erst eine systematische, mehrkriterielle Prüfung sichtbar.
Die Auswertung der Chatverläufe zeigt, ob Kunden jetzt besser zurechtkommen. Dieselben Chatverläufe erzählen aber noch mehr über Ihre Kunden.
Das Wissen aus den Chats ergänzt Marktforschung.
Im Chat soll der Agent Umbuchungen, Stornierungen und Erstattungen zuverlässig erledigen. Welche Anliegen Kunden darüber hinaus haben, zeigt sich, wenn jemand die Chats nach wiederkehrenden Themen ordnet.
Wir nennen das gern Marktforschung ohne Fragebogen: Kunden fragen etwa nach Leistungen, die es noch nicht gibt. Oder sie beschreiben ein Problem mit Worten, die in keiner Produktbeschreibung vorkommen. Für Sie als Produktteam sind das Hinweise auf neue Use Cases. Für die Fachbereiche sind es Einblicke in Marken und Märkte.
Genutzt wird dieses Wissen nach unserer Erfahrung bisher kaum. Das liegt entweder am fehlenden Bewusstsein für diese Informationsquelle oder an einer Zuständigkeitslücke: Das Produktteam kann den Fachbereichen meist nur Prioritäten vorschlagen, entscheiden müssen diese selbst. Die Fachbereiche können also priorisieren, haben aber weder Zugang zu den Chats noch Zeit, sie auszuwerten.
Einen Teil der Antworten kennen Service und Produktteam bereits.
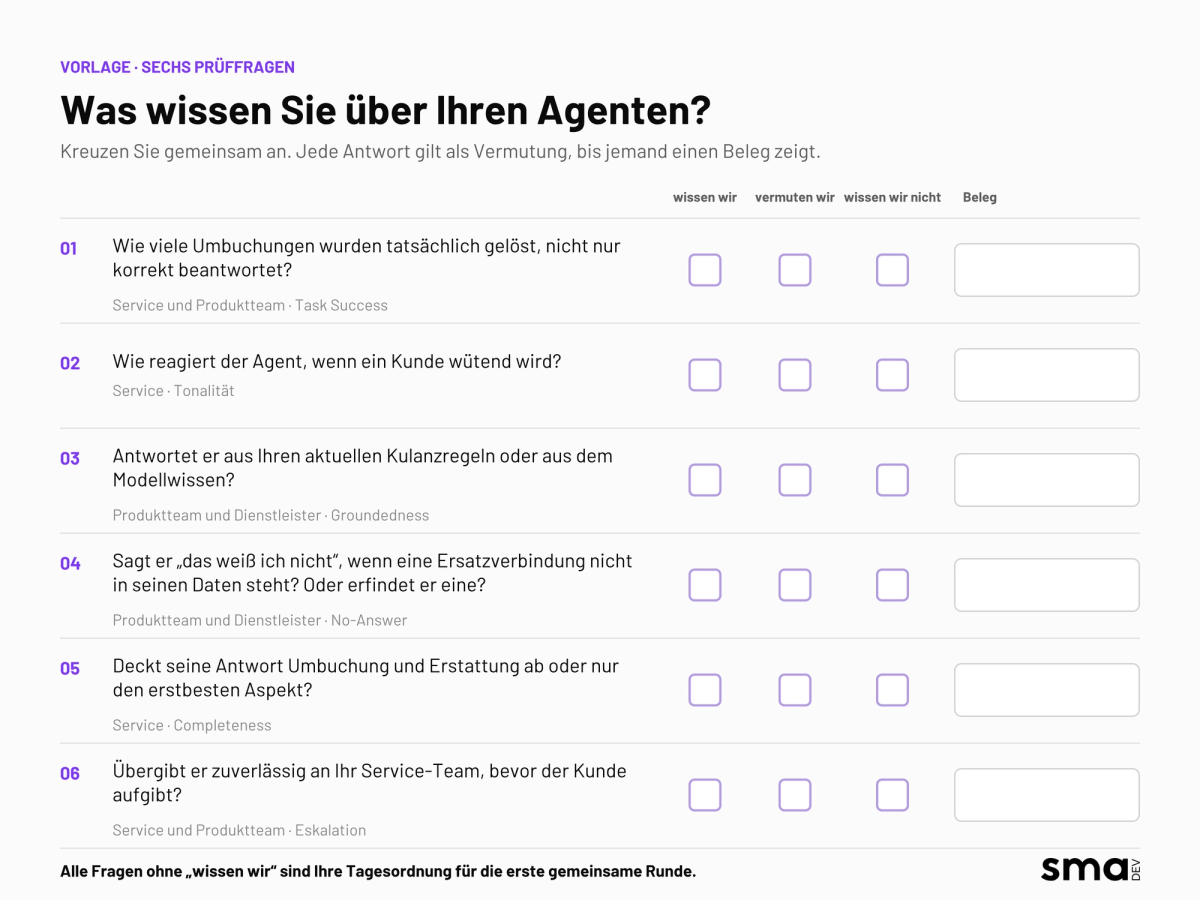
Wie gut der Agent arbeitet, steht in seinen Chats. Einen Teil davon kennen Service und Produktteam aus dem Alltag: der Service aus dem, was er von Kunden hört, das Produktteam aus dem, was es beim Dienstleister beauftragt. Wo das Bekannte aufhört, zeigen sechs Fragen.
- Wie viele Umbuchungen wurden tatsächlich gelöst, nicht nur korrekt beantwortet? (Service- und Produktteam)
- Wie reagiert der Agent, wenn ein Kunde wütend wird? (Service)
- Antwortet er aus Ihren aktuellen Kulanzregeln oder aus dem Modellwissen? (Produktteam und Dienstleister)
- Sagt er „Das weiß ich nicht“, wenn eine Ersatzverbindung nicht in seinen Daten steht? Oder erfindet er eine? (Produktteam und Dienstleister)
- Deckt seine Antwort Umbuchung und Erstattung ab oder nur den erstbesten Aspekt? (Service)
- Übergibt er zuverlässig an Ihr Service-Team, bevor der Kunde aufgibt? (Service- und Produktteam)
Gehen Sie die Fragen ruhig gemeinsam durch und vermerken Sie bei jeder „wissen wir“, „vermuten wir“ oder „wissen wir nicht“. Einige davon beantwortet erst eine systematische Auswertung der Chats. Eine ausfüllbare Vorlage mit diesen Fragen und fünf Entscheidungskriterien finden Sie im Whitepaper. Alle Fragen ohne „wissen wir“ sind dann die offenen Punkte für Ihre erste gemeinsame Runde.
Ein fester Tagesordnungspunkt ersetzt Bring- und Holschuld.
Am besten bekommt das Thema einen festen Tagesordnungspunkt in einem bestehenden Jour fixe. Mit von der Partie sind dann Service und Produktteam, IT oder Dienstleister und eine Person aus dem Fachbereich, die über Prioritäten, Budget und Ressourcen entscheiden kann. So wird aus Bring- und Holschuld ein gemeinsames Commitment.
Beim ersten Mal sortiert die Runde die offenen Punkte aus den sechs Fragen und klärt für jeden, wie gesichert die Antwort ist. Dabei gilt am besten folgender Default: Jede Antwort zählt als Vermutung, bis jemand einen Beleg zeigt.
Für manche Punkte reichen vorhandene Datenpunkte. Andere brauchen eine systematische Auswertung der Chats, zum Beispiel die Frage, ob Ihr Agent aus Ihren Quellen antwortet. Bestandsaufnahme, Tests, Freigabe und laufende Beobachtung bilden dabei den Qualitätskreislauf, den AI Evals beschreiben. Die Auswertung kann eine unabhängige KI-Beratung übernehmen.
Ab dann steht das Thema bei jedem Jour fixe auf der Agenda, und die nächsten offenen Punkte wandern auf die Roadmap. Gemeinsam obliegt es den Beteiligten, den Evals-Prozess zu verstetigen. Damit hat die Frage, ob Ihr Agent seine Aufgabe erfüllt, einen festen Platz auf der Agenda.
Häufige Fragen zur Qualität von KI-Agenten im Kundenservice
Wie misst man, ob ein KI-Agent im Kundenservice Anliegen wirklich löst?
Ein guter Startpunkt ist die Erstlösungsquote: Wie viele Kunden melden sich nach dem Chat nicht noch einmal per Telefon oder Mail? Ergänzend zeigt eine Auswertung der Chatverläufe, ob die Antwort das eigentliche Anliegen getroffen hat und nicht nur sachlich richtig war.
Warum gibt ein KI-Agent veraltete Antworten, obwohl der Hilfeartikel aktualisiert wurde?
Häufig liegt die alte Fassung noch in der Wissensdatenbank, und der Agent findet beide Versionen. Auch die Gliederung der Inhalte oder eine Änderung am Prompt beeinflussen, welche Stelle er für seine Antwort heranzieht.
Wer ist für die Qualität eines KI-Agenten nach dem Go-live verantwortlich?
Mehrere Teams gemeinsam: Der Service pflegt Hilfeartikel und kennt die Kundenanliegen, Produktteam und Dienstleister verantworten Retrieval und Prompts, die IT die angebundenen Systeme. Ein fester Tagesordnungspunkt im Jour fixe bündelt diese Zuständigkeiten.
Was sind AI-Evals?
AI-Evals sind ein kontinuierlicher Qualitätskreislauf für KI-Systeme. Er verbindet die Analyse realer Nutzung, wiederholbare Tests vor jeder Änderung und laufende Beobachtung im Betrieb.
Wie oft sollte man die Qualität eines Chatbots prüfen?
Spätestens bei jeder Änderung an Inhalten, Prompts oder Modell, denn jede dieser Änderungen kann das Verhalten des Agenten verschieben. Im Alltag bewährt sich ein fester Rhythmus, zum Beispiel ein Punkt in jedem Jour fixe.
Aus dem Blog
Weitere Insights & Aktuelles.
AI Evals: Fünf Dimensionen für produktive KI-Systeme
Im laufenden Betrieb Ihres KI-Systems fallen Ihnen drei Dinge auf. Der Token-Verbrauch steigt von einem Sprint zum nächsten um 40 %, ohne dass eine Konfigurationsänderung das erklären würde. Nach einem Prompt-Update verändert sich die Antwortqualität spürbar; das Team empfindet sie als schlechter, kann aber nicht benennen, warum. Und Ihr RAG-System liefert Aussagen, die in keinem […]
Mehr lesen→
LLM-Halluzinationen: Warum korrekte Daten das Problem nicht lösen
Ein KI-System hat die AGB Ihres Unternehmens vollständig geladen. Es kennt jeden Paragraphen. Und trotzdem verspricht es einem Kunden eine Leistung, die rechtlich nicht gedeckt ist. Das passiert täglich in Systemen, die längst als produktionsreif gelten. Der Grund liegt nicht im fehlenden Datenzugriff. Er liegt darin, wie das Modell mit den Daten umgeht. Was ist […]
Mehr lesen→
Fehlerfreie KI-Anwendungen entwickeln: Die Vorteile von AI-Evaluations
Die Herausforderungen in KI-Projekten verschieben sich drastisch: Wir sprechen nicht mehr von Systemabstürzen, sondern vom sogenannten „Silent Failure“. Anwendungen liefern technisch einwandfreie Datenpakete aus, während der inhaltliche Kern zu halluzinieren beginnt, Compliance-Richtlinien verletzt werden oder die Markenreputation durch einen falschen Tonfall gefährdet wird. Technisch gesehen ist das System ein Erfolg. Der Live-Betrieb liefert jedoch andere […]
Mehr lesen→
Glossar: RAG-Systeme, Embeddings und KI-Evaluationen verstehen
Warum dieses Glossar? In fast jedem Discovery-Gespräch passiert dasselbe: Der Entscheider nickt bei ‚RAG‘, aber meint etwas anderes als der Entwickler im selben Raum. Dieses Glossar soll hier Abhilfe schaffen.
Mehr lesen→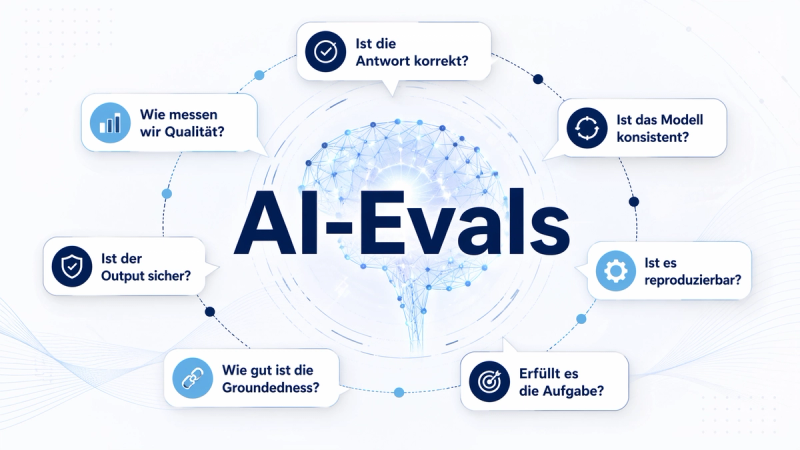
Effizienzsteigerung durch KI-Qualität: Was sind AI-Evaluations (AI-Evals)?
Die beeindruckende Geschwindigkeit, mit der KI-Prototypen heute entstehen, markiert den Beginn einer neuen Ära betrieblicher Effizienz. Doch der
Mehr lesen→
„Black-Box RAG?“ – Warum RAG-Systeme still versagen und wie man es früh erkennt
In fast jedem Discovery-Gespräch kommt derselbe Moment: Das RAG-System läuft seit Wochen in Produktion, die Entwickler sind zufrieden, das Management hat abgenickt. Dann fragt jemand das System nach einem internen Prozess und bekommt eine Antwort, die sachlich klingt, aber veraltet ist. Niemand hat es gemeldet. Niemand hat es gemessen. Das ist kein Einzelfall. Qualitätsverluste in […]
Mehr lesen→