
Lösungsquote des KI-Agenten: So messen Sie, wie viele Anliegen Ihr Agent im Kundenservice wirklich erledigt
Ein KI-Agent im Kundenservice kann eine hohe Lösungsquote melden (im Englischen oft „Resolution Rate“), während im Callcenter die Anrufe zu genau den Themen steigen, die er laut Dashboard löst. Das liegt an der Zählweise. Die Zahl im Dashboard ist häufig die sogenannte Containment-Rate (Eindämmungsquote): Sie fragt, ob ein Mensch ins Gespräch eingestiegen ist, die Lösungsquote dagegen, ob das Problem des Kunden gelöst wurde. Das bedeutet:
Ein Kunde, der die richtige Antwort bekommt, und einer, der aufgibt, zählen beide als erfolgreich, solange niemand zusätzlich Lösung, Abbruch und Folgekontakte prüft.
Wie groß die Lücke werden kann, zeigt eine Studie des Agenten-Anbieters Ada mit dem Marktforscher NewtonX aus dem Frühjahr 2026. Nur 24 Prozent der befragten Verbraucher gaben an, dass ihr letztes Anliegen im KI-Kundenservice vollständig von der KI gelöst wurde. Auf Unternehmensseite können aber 42 Prozent die Gespräche ihrer KI nicht mit den Ergebnissen danach verknüpfen, also etwa mit späteren Anrufen zum selben Thema.
In diesem Beitrag erfahren Sie, worin sich Accuracy und Lösungsquote aus Kundensicht unterscheiden und wie Sie die tatsächliche Lösungsquote Ihres KI-Agenten mit Folgekontakten, Abbruchmustern und Stichproben aus Ihren Gesprächsdaten annähern.
Welche Gespräche zählt das Dashboard als gelöst, obwohl das Anliegen offen ist?
Zwei Fälle kommen in Gesprächsdaten immer wieder vor.
Ein Kunde fragt, wie er die Erstattung für eine stornierte Reise bekommt. Der Agent nennt die richtige Frist, erklärt die Kulanzregel und verlinkt das Erstattungsformular. Der Kunde schließt das Fenster, im Dashboard zählt das Gespräch als gelöst. Am nächsten Tag ruft der Kunde im Callcenter an, weil er gestern seine Buchungsnummer nicht kannte, die er im verlinkten Formular hätte eintragen müssen. Inhaltlich war die Antwort des KI-Agenten korrekt. Erledigt hat sie das Anliegen allerdings nicht.
Oder: ein Kunde formuliert seine Frage dreimal um, bekommt jedes Mal eine Antwort zu einem anderen Aspekt und schließt dann den Chat. Auch dieses Gespräch endet ohne Übergabe an einen Mitarbeiter. Solche Fälle sind schwer zu sehen, weil sie keine Spur hinterlassen: In der oben genannten Ada-Studie haben 11 Prozent der Verbraucher die Interaktion ganz abgebrochen, ohne sich zu beschweren oder nachzufassen. Sie tauchen weder in Beschwerden noch im Callcenter auf.
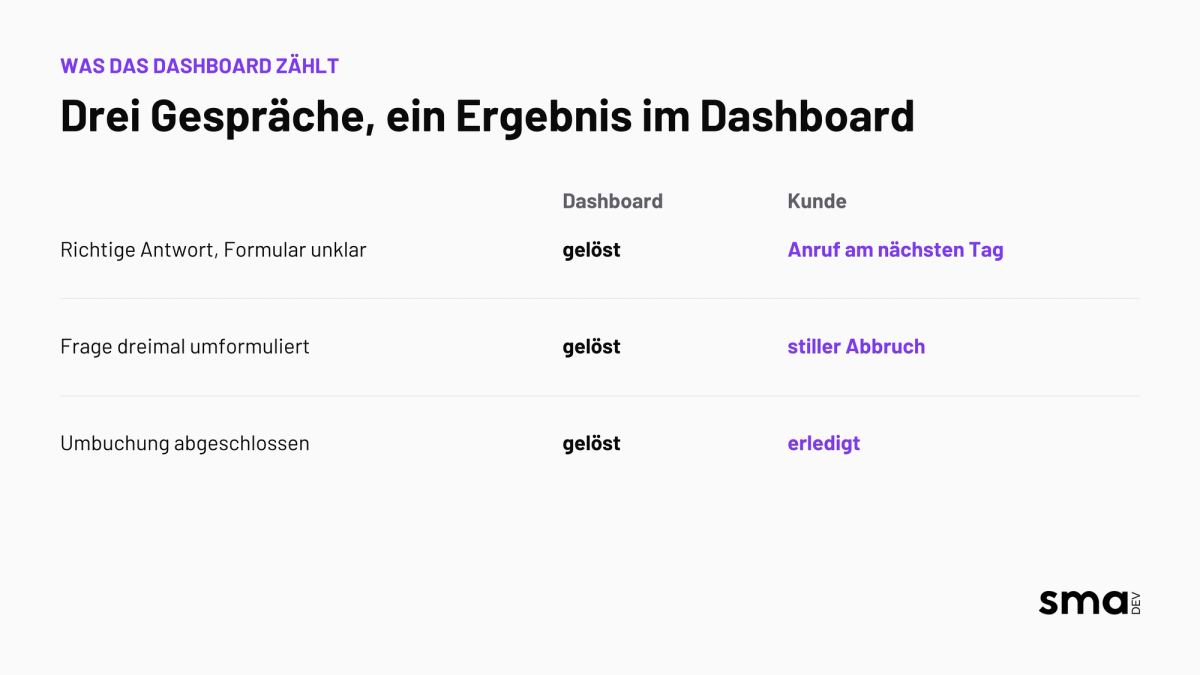
Was misst Accuracy, was misst die Lösungsquote aus Kundensicht?
Beide Zahlen sind wertvoll, sie beantworten nur verschiedene Fragen.
Accuracy (Antwortgenauigkeit) beantwortet die Frage, ob die Antwort des Agenten inhaltlich stimmt. Im Alltag bemerken Sie sie an Beschwerden über falsche Auskünfte und an Prüfungen durch Fachbereich oder Compliance.
Die Lösungsquote aus Kundensicht (verwandt mit der First Contact Resolution) beantwortet die Frage, ob das Anliegen des Kunden nach dem Gespräch erledigt ist. Im Alltag bemerken Sie sie an Folgeanrufen, Wiederholkontakten und Rückmeldungen aus dem Service-Team.
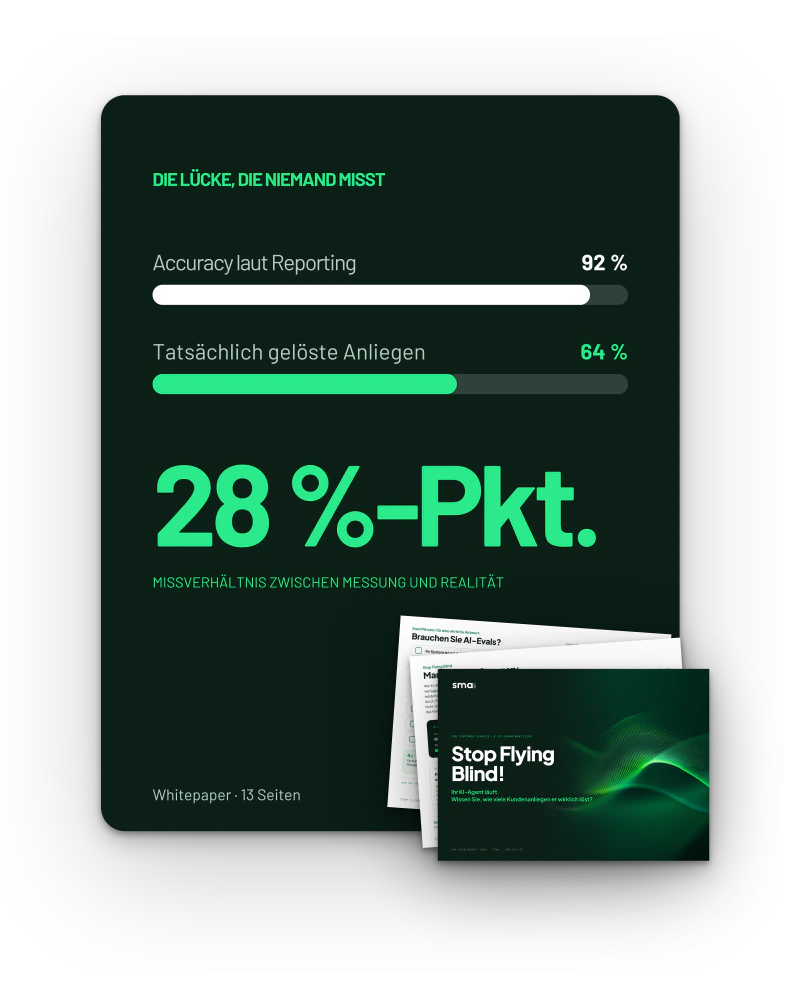
Ein Agent kann bei der Accuracy sehr gut abschneiden und trotzdem viele Kunden ins Callcenter schicken. Die Gründe liegen selten im Wissen des Agenten. Häufiger erkennt er nicht, was der Kunde eigentlich will, oder er beantwortet nur einen Teil der Anfrage.
Wenn Sie beide Zahlen nebeneinander sehen, finden Sie heraus, wo Ihr Agent nachbessern muss: an seinem Wissen oder daran, dass er Anliegen richtig erkennt und Vorgänge wie eine Erstattung selbst abschließt. Daraus wird ein klarer Auftrag für Ihr Entwicklungsteam oder Ihren Dienstleister.
Lösungsquote des KI-Agenten bewerten: drei Signale aus Ihren Systemen
Eine exakte Lösungsquote aus Kundensicht gibt es selten auf Knopfdruck. Mit drei Signalen, die größtenteils schon in Ihren Systemen liegen, kommen Sie ihr nah.
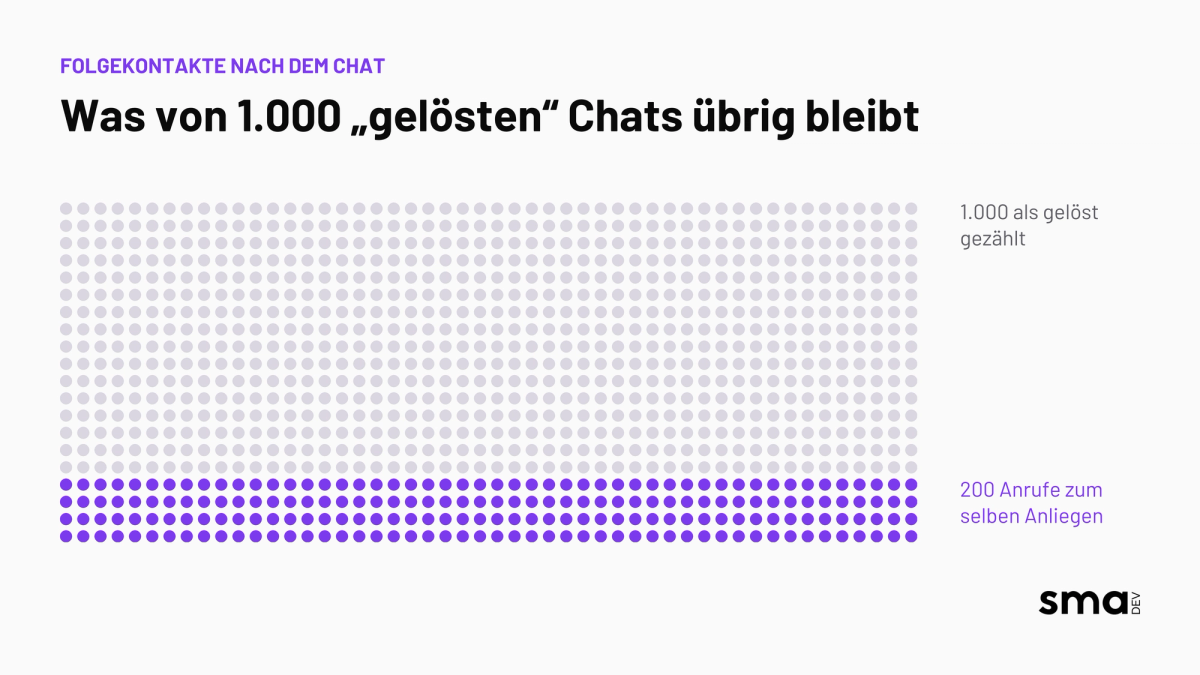
- Folgekontakte zum selben Thema. Gleichen Sie ab, ob ein Kunde nach einem Chat erneut Kontakt aufnimmt, per Telefon, Mail oder wieder im Chat, und zwar zum selben Anliegen. Als Zeitfenster empfehlen wir unseren Kunden je nach Branche etwa 48 Stunden oder 7 Tage nach Erstkontakt. Bei einer Umbuchung meldet sich ein Kunde schneller als bei einer Erstattung, auf die er ohnehin einige Tage wartet.
Angenommen, von 1.000 als gelöst gezählten Umbuchungs-Chats folgt bei 200 ein Anruf zur selben Buchung. Dann liegt die Quote für dieses Thema eher bei 80 als bei 100 Prozent, und Sie sehen genau, wo Ihr Service nacharbeitet.
- Abbruchmuster. Schauen Sie, an welcher Stelle Gespräche enden. Bricht ein Kunde direkt nach einer bestimmten Antwort ab oder nachdem er seine Frage mehrfach umformuliert hat, spricht viel für ein offenes Anliegen. Häufen sich solche Abbrüche bei einem Thema, wissen Sie, wo Ihr Agent als Nächstes überarbeitet werden sollte. Mit diesem Signal erfassen Sie auch die stillen Abbrüche, die in keiner Beschwerde auftauchen.
- Stichproben echter Gespräche. Lesen Sie regelmäßig zufällig ausgewählte Chats gemeinsam mit jemandem aus dem Service, zum Beispiel 30 pro Woche. Die Leitfrage für jedes Gespräch lautet: Wäre ich als Kunde jetzt fertig? Die Stichprobe liefert Ihnen das „Warum“ hinter den Zahlen, also ob der Agent das Anliegen falsch verstanden, nur teilweise beantwortet oder einen Vorgang nicht ausgelöst hat. Für eine belastbare Quote reicht sie allerdings nicht. Wenn Sie die Lösungsquote dauerhaft berichten möchten, braucht es eine automatisierte Bewertung aller Gespräche.
Wo fangen Sie an?
Für den Einstieg haben wir einen 14-Tage-Selbsttest entwickelt, den Sie mit Ihrem eigenen Team durchführen können. Damit stellen Sie die Lösungsquote aus Kundensicht, angenähert über Folgekontakte, Abbruchmuster und Stichproben, der Zahl in Ihrem Dashboard gegenüber. Die Größe der Lücke zeigt Ihnen, wie belastbar Ihr bisheriges Reporting ist. Berichten Sie die angenäherte Quote künftig mit, können Sie steigende Anrufzahlen im Callcenter erklären und wissen, welche Themen Priorität haben und was am Agenten als Nächstes überarbeitet werden muss.
Zeigt der Selbsttest eine deutliche Lücke, lohnt es sich im nächsten Schritt, die Lösungsquote dauerhaft und für alle Gespräche zu messen. Dazu gehören eine automatisierte Bewertung aller Gespräche, feste Testfälle für jede Änderung am Agenten und laufende Beobachtung im Betrieb. Das fasst man unter dem Begriff AI-Evals zusammen.
Unser Team prüft als unabhängiger Dritter die Qualität produktiver KI-Agenten auf Basis echter Konversationen und Traces, d. h. der protokollierten Einzelschritte jedes Gesprächs. Die Befunde gehören Ihnen, die Umsetzung übernimmt Ihre IT oder Ihr Dienstleister.
Den Selbsttest finden Sie in unserer Checkliste, zusammen mit sieben Fragen, mit denen Sie prüfen, ob Ihr Team Evals und Monitoring selbst aufbauen kann: Checkliste herunterladen.
Häufige Fragen zur Lösungsquote eines KI-Agenten
Was ist die Lösungsquote eines KI-Agenten?
Die Lösungsquote eines KI-Agenten gibt an, wie viele Anliegen nach dem Gespräch aus Kundensicht erledigt sind. Sie fragt, ob das Problem des Kunden gelöst wurde. Eine exakte Quote gibt es selten auf Knopfdruck. Folgekontakte, Abbruchmuster und Stichproben echter Gespräche nähern sie an.
Was ist der Unterschied zwischen Lösungsquote und Containment-Rate?
Die Containment-Rate (Eindämmungsquote) fragt, ob ein Mensch ins Gespräch eingestiegen ist. Die Lösungsquote fragt, ob das Anliegen des Kunden gelöst wurde. Ein Kunde, der ohne Lösung aufgibt, zählt in der Containment-Rate als Erfolg, in der Lösungsquote nicht.
Ist die Lösungsquote dasselbe wie die First Contact Resolution?
Die beiden Kennzahlen sind verwandt. Beide fragen, ob das Anliegen des Kunden erledigt ist. Ein Folgekontakt zum selben Anliegen zeigt in beiden Fällen, dass das Anliegen offen geblieben ist.
Warum reicht Accuracy nicht aus, um einen KI-Agenten zu bewerten?
Accuracy (Antwortgenauigkeit) prüft, ob die Antwort inhaltlich stimmt. Ein Agent kann korrekt antworten und das Anliegen trotzdem offen lassen, etwa weil er nicht erkennt, was der Kunde will, oder nur einen Teil der Anfrage beantwortet. Erst beide Zahlen nebeneinander zeigen, ob der Agent am Wissen oder an der Anliegen-Erkennung nachbessern muss.
Woran erkennt man stille Abbrüche im Chat?
Stille Abbrüche hinterlassen weder eine Beschwerde noch einen Anruf. Sie zeigen sich in Abbruchmustern: Ein Kunde formuliert seine Frage mehrfach um oder beendet den Chat direkt nach einer bestimmten Antwort. Häufen sich solche Abbrüche bei einem Thema, spricht viel für ein offenes Anliegen.
Aus dem Blog
Weitere Insights & Aktuelles.
Kosten pro gelöstem Anliegen: KI-Agent im Kundenservice
Günstig pro Anfrage heißt nicht günstig pro Kunde. Messen Sie die Kosten pro gelöstem Anliegen und gewinnen Sie die Kontrolle über das Budget Ihres KI-Agenten zurück.
Mehr lesen→
Decision Model im Kundenservice: Jev senkt Kosten
Ihr KI-Agent trifft in jedem Gespräch mehrere Entscheidungen im Hintergrund, und häufig bezahlen Sie dafür ein großes Sprachmodell. Hier lesen Sie, welche dieser Entscheidungen ein Decision Model wie Jev günstiger übernimmt und wie Sie das mit Ihren eigenen Chats prüfen, bevor Sie umstellen.
Mehr lesen→
KI-Agent im Kundenservice verbessern
Ihr KI-Agent ist live, und jedes Team kümmert sich um seinen Teil. Wer schaut regelmäßig in seine Chats und macht ihn besser?
Mehr lesen→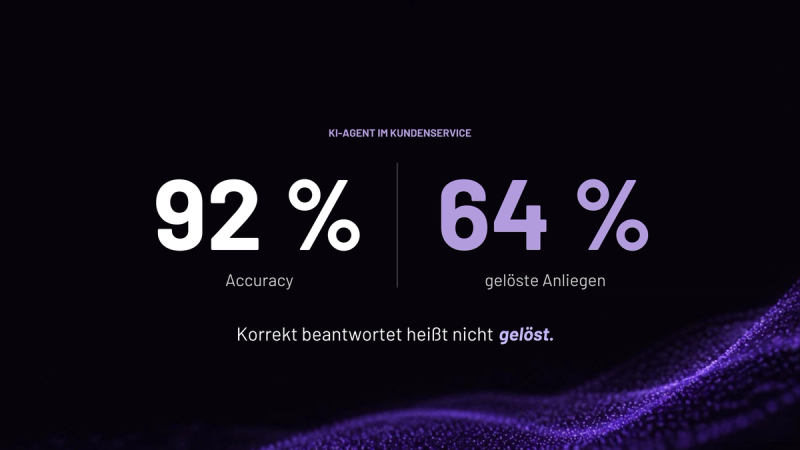
KI-Agent im Kundenservice: Qualität nach dem Go-live prüfen
Ihr KI-Agent im Kundenservice antwortet schnell und sachlich richtig. Trotzdem rufen Kunden danach an. Wer prüft, ob er Anliegen wirklich löst? Sechs Fragen und eine Routine für Service, Produktteam und IT.
Mehr lesen→
AI Evals: Fünf Dimensionen für produktive KI-Systeme
Im laufenden Betrieb Ihres KI-Systems fallen Ihnen drei Dinge auf. Der Token-Verbrauch steigt von einem Sprint zum nächsten um 40 %, ohne dass eine Konfigurationsänderung das erklären würde. Nach einem Prompt-Update verändert sich die Antwortqualität spürbar; das Team empfindet sie als schlechter, kann aber nicht benennen, warum. Und Ihr RAG-System liefert Aussagen, die in keinem […]
Mehr lesen→
LLM-Halluzinationen: Warum korrekte Daten das Problem nicht lösen
Ein KI-System hat die AGB Ihres Unternehmens vollständig geladen. Es kennt jeden Paragraphen. Und trotzdem verspricht es einem Kunden eine Leistung, die rechtlich nicht gedeckt ist. Das passiert täglich in Systemen, die längst als produktionsreif gelten. Der Grund liegt nicht im fehlenden Datenzugriff. Er liegt darin, wie das Modell mit den Daten umgeht. Was ist […]
Mehr lesen→