
Qualitätssicherung im KI-Kundenservice: Wer verantwortet den Agenten?
Ein KI-Agent im Kundenservice kann nach dem Go-live zuverlässig laufen und mit der Zeit trotzdem falsche Auskünfte geben. Häufig liegt das daran, dass die Verantwortung für den KI-Agenten im Kundenservice nicht geregelt ist.
Denn ein Agent muss regelmäßig gepflegt und überprüft werden. Dass die Wissensbasis z.B. bei neuen Tarifen oder Regeln nachgezogen werden muss, ist in der Regel klar. Weniger geregelt ist, wer entscheidet, wenn sich am Agenten selbst etwas ändert: wenn der Anbieter das Sprachmodell aktualisiert, ein neues Modell verfügbar wird oder der Agent zusätzliche Anliegen übernehmen soll. Nach jeder dieser Änderungen kann er anders antworten als vorher. Das muss jemand prüfen und verantworten. Außerdem braucht es jemanden, der Neuerungen aktiv verfolgt und entscheidet, welche davon der Agent nutzen soll.
Wie oft diese Zuständigkeit offen bleibt, zeigt eine Befragung des Softwareanbieters Ivanti unter 1.500 IT-Fachleuten aus dem Frühjahr 2026. Zwar gaben 85 Prozent an, dass jeder KI-Agent einen benannten Owner hat. Dass die Zuständigkeit tatsächlich klar ist, sagten nur 42 Prozent
Für Serviceverantwortliche ist das eine Chance. Wer die Qualität des Agenten verantwortet, sorgt dafür, dass er Anliegen tatsächlich löst. Das entlastet das eigene Team und zahlt direkt auf Unternehmensziele wie Kundenzufriedenheit und Servicekosten ein.
In diesem Beitrag erfahren Sie, warum die laufende Pflege eines KI-Agenten nach dem Go-live zwischen den Zuständigkeiten verloren geht, welche Folgen das haben kann und wie Sie die Verantwortung klar regeln.
Warum geht die Pflege des Agenten nach dem Go-live oft unter?
Ein KI-Agent wird als Projekt eingeführt, mit Projektleitung, Budget und Abnahmekriterien. Nach Go-live, Stabilisierungsphase und Übergabe an den Betrieb wird das Projekt abgenommen, und mit ihm enden Budget und Projektrollen. Jede Seite übernimmt danach den Teil, für den sie ohnehin zuständig ist.
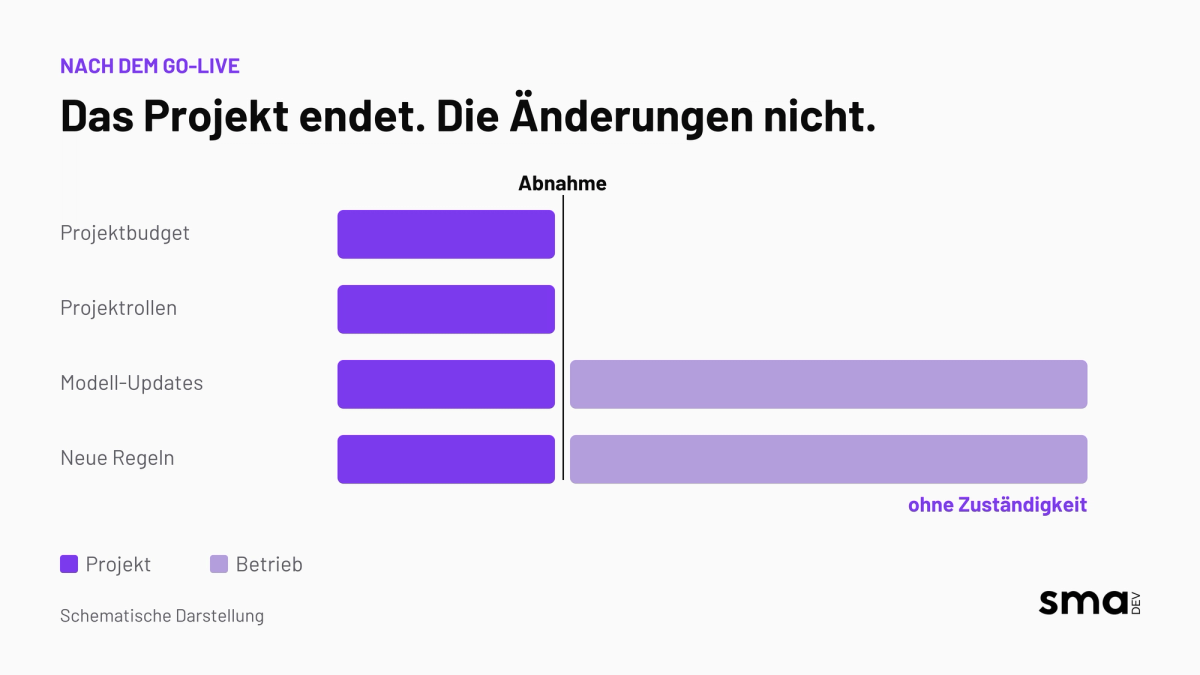
IT oder Dienstleister verantworten nach dem Go-live Betrieb, Verfügbarkeit, Kosten und technische Fehler. Offen bleibt, ob die Antworten inhaltlich stimmen und Anliegen lösen.
Der Fachbereich verantwortet die Use Cases und Regeln, die er vor dem Go-live geliefert hat. Offen bleibt, ob der Agent spätere Regeländerungen kennt.
Das Produktteam verantwortet die nächsten Use Cases auf der Roadmap. Offen bleibt, wie gut die bestehenden im Alltag laufen.
Der Kundenservice kümmert sich um Kunden, die anrufen oder sich beschweren. Offen bleibt, ob die Ursache beim Agenten liegt und wer sie behebt.
Die Antwortqualität betrifft alle vier Seiten. Geprüft wird sie im Projekt vor dem Go-live, mit Testfällen und Abnahme. Danach fehlt häufig jemand, der diese Tests nach jedem Modell-Update oder jeder neuen Funktion wiederholt und echte Gespräche regelmäßig auswertet. Diese laufende Prüfung nennt man AI-Evals.
Was passiert, wenn niemand zuständig ist?
Ohne klare Zuständigkeit weiß niemand im Unternehmen verlässlich, ob der Agent gute Antworten liefert. Im schlimmsten Fall wirkt sich das so auf Kunden und Geschäft aus.
Ihr Image leidet.
Aktualisiert der Anbieter das Modell oder passt der Dienstleister den Prompt an, prüft ohne klare Zuständigkeit niemand vorab mit festen Testfällen, ob die Antworten noch stimmen. Verschlechterungen fallen dann erst im Kundengespräch auf, im schlimmsten Fall sogar öffentlich, wie bei einem Paketdienst im Januar 2024: Nach einem Update verhielt sich der Kundenchat unerwartet und beschimpfte einen Kunden, woraufhin das Unternehmen den KI-Teil sofort abschaltete.
Servicekosten steigen, während Kunden unzufrieden sind
Ohne regelmäßige Auswertung echter Gespräche bleiben auch kleinere Verschlechterungen unbemerkt, etwa wenn Antworten häufiger unvollständig sind oder Kunden bei einem Thema öfter abbrechen und anschließend zum Telefon greifen. Im Service zeigt sich das an steigenden Anrufzahlen, ohne dass sich belegen lässt, dass der Agent die Ursache ist. Am Ende zahlen Sie doppelt: für den KI-Agenten und für das Service-Team, das dieselben Anliegen noch einmal bearbeitet.
Kunden wandern ab, Umsätze gehen verloren.
Das Service-Team erkennt Fehler des Agenten oft als Erstes und meldet sie weiter. Im Backlog stehen diese Hinweise dann neben neuen Use Cases, ohne dass jemand bewertet, wie häufig und wie dringend sie sind. So trifft derselbe Fehler Woche für Woche weitere Kunden, und wer etwa bei einer Umbuchung oder Bestellung keine Hilfe bekommt, bricht ab und kauft im Zweifel bei der Konkurrenz.
Sie zahlen mehr als nötig.
Die Entwicklung bei KI-Modellen ist so schnell wie in kaum einem anderen Technologiefeld: In kurzen Abständen erscheinen neue Modelle und Funktionen, die oft günstiger bei gleicher Qualität sind oder dem Agenten ermöglichen, Vorgänge wie eine Erstattung selbst abzuschließen. Solange niemand diese Neuerungen prüft und über ihren Einsatz entscheidet, bleibt der Agent auf dem Stand des Go-live, und mögliche Einsparungen im Betrieb wie im Service bleiben ungenutzt.
So regeln Sie die Verantwortung für den KI-Agenten im Kundenservice.
Ownership bedeutet, dass eine Person für die inhaltliche Qualität des Agenten verantwortlich ist und über die Mittel verfügt, diese Qualität zu verbessern. Dafür braucht es drei Voraussetzungen.
Eine benannte Person mit Zeit und Handlungsspielraum
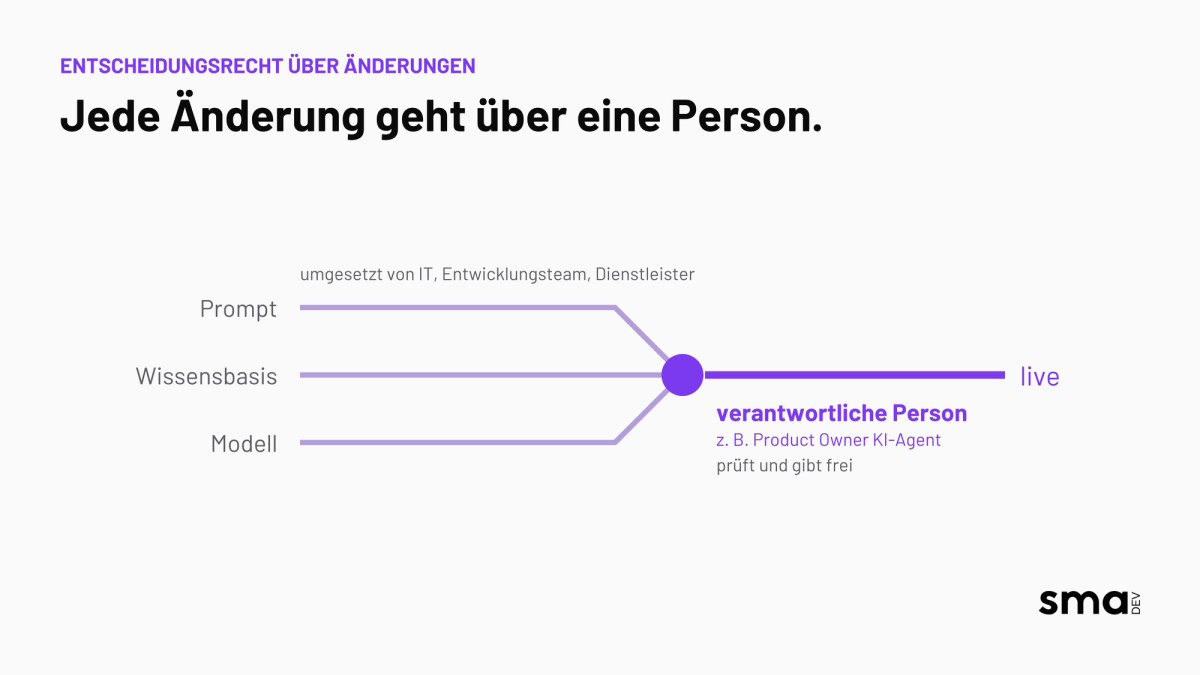
Verantwortlich ist eine konkrete Person, oft in der Rolle "Product Owner KI-Agent", kein Team. Diese Person darf entscheiden, welche Themen Vorrang haben, und Aufträge an IT, Entwicklungsteam oder Dienstleister vergeben, ohne dafür jedes Mal die Zustimmung einer höheren Ebene einzuholen. Für diese Aufgabe steht ihr ein fester Anteil ihrer Arbeitszeit zur Verfügung, der auch im Tagesgeschäft erhalten bleibt. Mit einem eigenen Budget kann der/die Verantwortliche Auswertungen und Änderungen beauftragen, ohne jedes Mal einen neuen Antrag stellen zu müssen.
Regelmäßige Durchsicht echter Gespräche.
Die verantwortliche Person beurteilt den Agenten nicht allein anhand des Dashboards, sondern kennt ihn aus seinen tatsächlichen Gesprächen. Dazu werden Stichproben, Beschwerden und Folgekontakte zum selben Thema ausgewertet, wie wir es im Beitrag zur Lösungsquote im KI-Kundenservice beschreiben. Außerdem muss die Person von den Fachbereichen über neue Regeln, Preise oder Prozesse informiert werden, damit die Pflege der Wissensbasis mit neuen Regeln Schritt hält.
Entscheidungsrecht über Änderungen.
Jede Änderung an Prompt, Wissensbasis oder Modell wird vor dem Live-Gang von der verantwortlichen Person geprüft und freigegeben. Er oder sie entscheidet auch, welcher Hinweis aus dem Service als Nächstes umgesetzt wird. Die Umsetzung übernehmen IT, Entwicklungsteam oder Dienstleister, die Bewertung des Ergebnisses liegt bei der verantwortlichen Person.
Wo fangen Sie an?
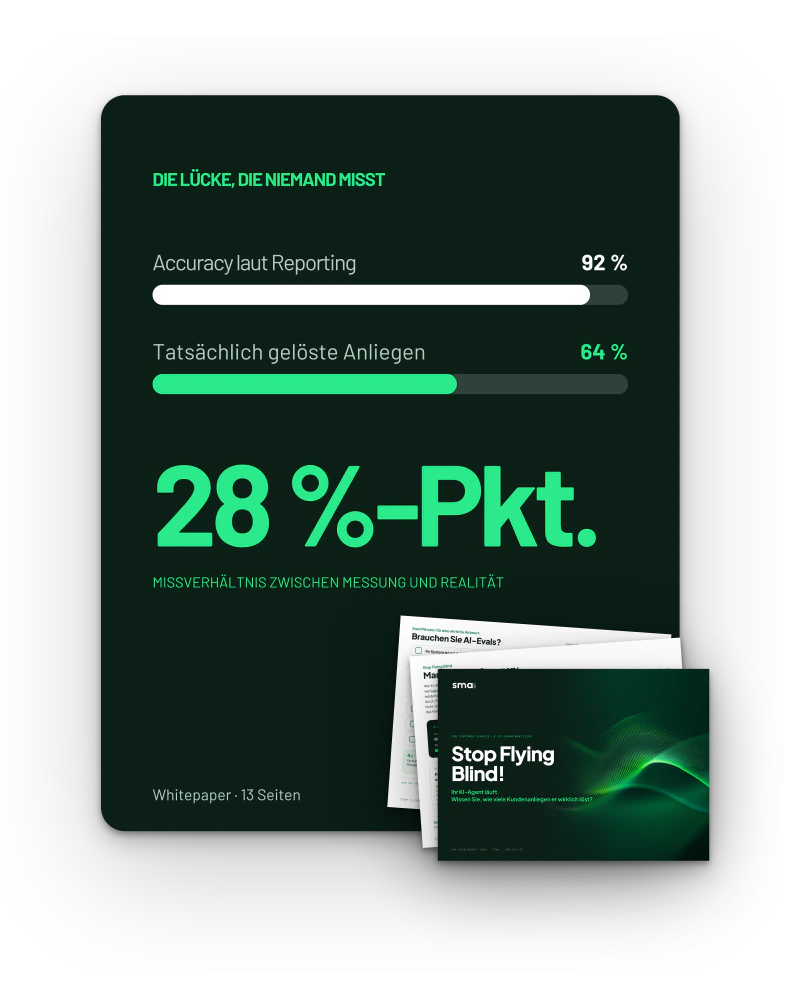
Für den Einstieg haben wir im Whitepaper „Stop Flying Blind!“ eine Checkliste mit sieben Punkten zusammengestellt. Damit schätzen Sie in zwei Minuten ein, ob Ihr Agent AI-Evals braucht. Einer der Punkte lautet: Die Antwortqualität hat noch keinen festen Owner. Nehmen Sie diesen Punkt in Ihren nächsten Jour fixe mit IT, Fachbereich, Produktteam und Service mit.
Damit die verantwortliche Person gut entscheiden kann, braucht sie ein verlässliches Bild davon, wie gut der Agent tatsächlich arbeitet. Unser Team prüft als unabhängiger Dritter die Qualität produktiver KI-Agenten auf Basis echter Konversationen und Traces (der protokollierten Einzelschritte jedes Gesprächs). Die Befunde gehören Ihnen, die Umsetzung übernimmt Ihre IT oder Ihr Dienstleister.
Häufige Fragen zur Qualitätssicherung im KI-Kundenservice
Wer ist für die Qualitätssicherung eines KI-Agenten im Kundenservice zuständig?
Eine konkrete Person, kein Team. Oft hat sie die Rolle "Product Owner KI-Agent". Sie verantwortet die inhaltliche Qualität des Agenten und hat dafür Zeit, Budget und das Entscheidungsrecht über Änderungen. IT, Entwicklungsteam oder Dienstleister setzen um, die Bewertung liegt bei ihr.
Was macht ein Product Owner KI-Agent?
Die Person legt fest, welche Themen Vorrang haben, und vergibt Aufträge an IT, Entwicklungsteam oder Dienstleister. Jede Änderung an Prompt, Wissensbasis oder Modell prüft sie vor dem Live-Gang und gibt sie frei. Außerdem wertet sie regelmäßig echte Gespräche aus: Stichproben, Beschwerden und Folgekontakte zum selben Thema.
Wann muss ein KI-Agent erneut geprüft werden?
Nach jeder Änderung am Agenten: wenn der Anbieter das Sprachmodell aktualisiert, ein neues Modell zum Einsatz kommt, der Prompt angepasst wird oder der Agent zusätzliche Anliegen übernimmt. Nach jeder dieser Änderungen kann er anders antworten als vorher. Neue Tarife, Regeln oder Prozesse verlangen zusätzlich eine Pflege der Wissensbasis.
Was sind AI-Evals?
AI-Evals sind die laufende Prüfung eines KI-Agenten im Betrieb. Dazu gehören feste Testfälle, die nach jedem Modell-Update oder jeder neuen Funktion wiederholt werden, und die regelmäßige Auswertung echter Gespräche.
Warum fehlt nach der Projektabnahme oft ein Owner für den KI-Agenten?
Ein KI-Agent wird als Projekt eingeführt. Mit der Abnahme enden Budget und Projektrollen, und jede Seite übernimmt nur ihren eigenen Teil: IT den Betrieb, der Fachbereich die Regeln, das Produktteam die nächsten Use Cases, der Service die Kunden. Die Antwortqualität betrifft alle vier, gehört aber keinem.
Aus dem Blog
Weitere Insights & Aktuelles.
Lösungsquote des KI-Agenten: Was Ihr Dashboard nicht zeigt
Ein Kunde mit richtiger Antwort und einer, der aufgibt, zählen im Dashboard oft gleich. Hier lesen Sie, wie Sie beide unterscheiden und die echte Lösungsquote Ihres KI-Agenten sichtbar machen.
Mehr lesen→
Kosten pro gelöstem Anliegen: KI-Agent im Kundenservice
Günstig pro Anfrage heißt nicht günstig pro Kunde. Messen Sie die Kosten pro gelöstem Anliegen und gewinnen Sie die Kontrolle über das Budget Ihres KI-Agenten zurück.
Mehr lesen→
Decision Model im Kundenservice: Jev senkt Kosten
Ihr KI-Agent trifft in jedem Gespräch mehrere Entscheidungen im Hintergrund, und häufig bezahlen Sie dafür ein großes Sprachmodell. Hier lesen Sie, welche dieser Entscheidungen ein Decision Model wie Jev günstiger übernimmt und wie Sie das mit Ihren eigenen Chats prüfen, bevor Sie umstellen.
Mehr lesen→
KI-Agent im Kundenservice verbessern
Ihr KI-Agent ist live, und jedes Team kümmert sich um seinen Teil. Wer schaut regelmäßig in seine Chats und macht ihn besser?
Mehr lesen→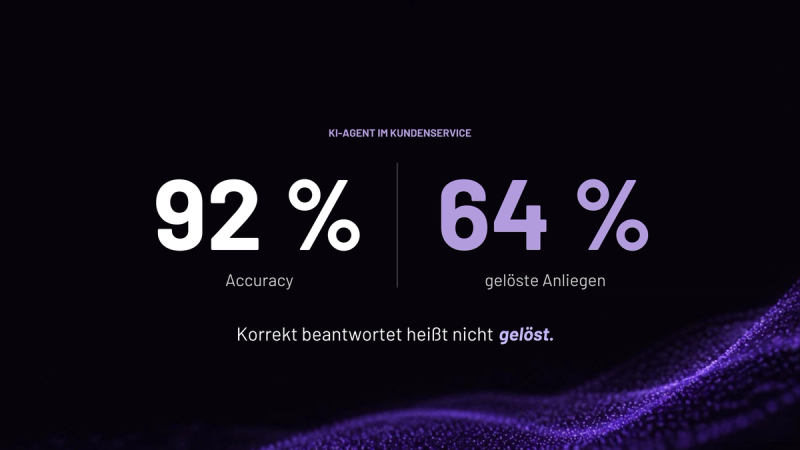
KI-Agent im Kundenservice: Qualität nach dem Go-live prüfen
Ihr KI-Agent im Kundenservice antwortet schnell und sachlich richtig. Trotzdem rufen Kunden danach an. Wer prüft, ob er Anliegen wirklich löst? Sechs Fragen und eine Routine für Service, Produktteam und IT.
Mehr lesen→
AI Evals: Fünf Dimensionen für produktive KI-Systeme
Im laufenden Betrieb Ihres KI-Systems fallen Ihnen drei Dinge auf. Der Token-Verbrauch steigt von einem Sprint zum nächsten um 40 %, ohne dass eine Konfigurationsänderung das erklären würde. Nach einem Prompt-Update verändert sich die Antwortqualität spürbar; das Team empfindet sie als schlechter, kann aber nicht benennen, warum. Und Ihr RAG-System liefert Aussagen, die in keinem […]
Mehr lesen→